AI出题的选项线索:带「完全」「一定」的那一项
生成的卷子可以不读材料就做:错误选项被写成正确项的夸张版,看到「只有」「从不」「全部」就能删。提示词里加一句话能关掉这条线索,但长度线索还在。
题目会从措辞里漏答案。错误选项被写成正确项的语气加强版:「它完全停止发酵」对「它仍在发酵,只是很慢」,考过几次试的人不用读材料就知道哪句是错的。这个判断不需要材料。于是用同一个模型出了四百道题,用一条正则把这处泄漏量出来,再拿同一套算式跑一遍一万四千零四十二道人写的题,看正常的线在哪。
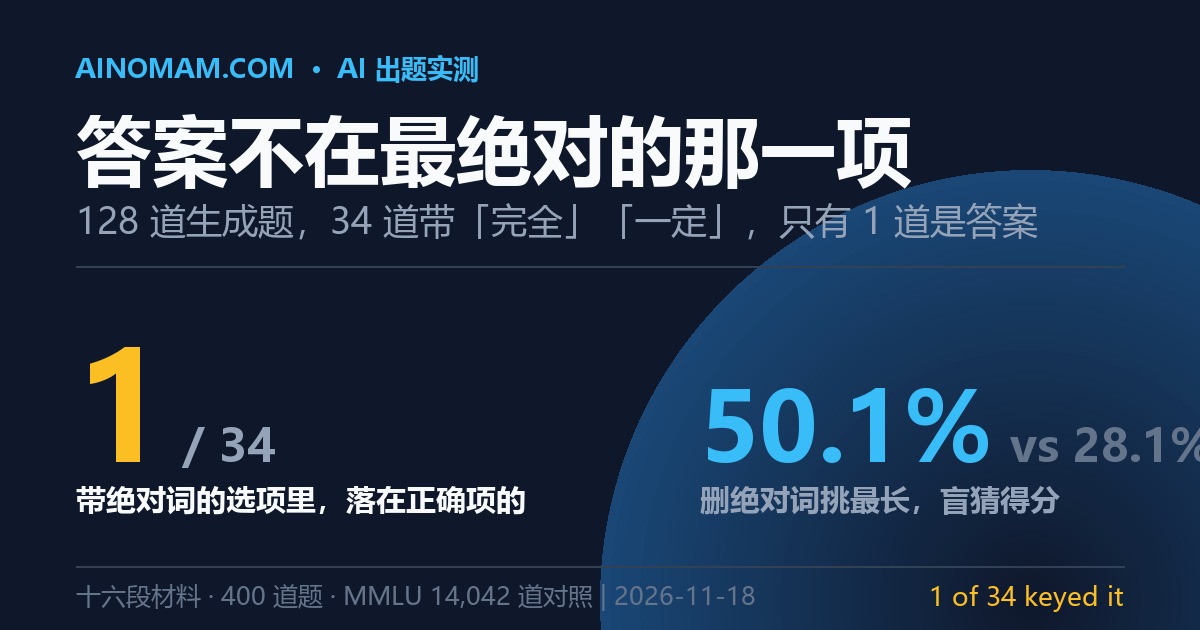
普通提示词下,128 道英文题里有 34 道的选项带绝对词,这 34 道里只有 1 道把绝对词放在正确项上。MMLU 里这条线索出现在 14.0% 的题里,其中 37.1% 落在正确项上。一个学生只要删掉含 always、never、all、none、only、entirely、completely、impossible、solely 的选项,在剩下的里均分猜,在生成卷上拿 29.2%,在 MMLU 上拿 25.0%。再加一条:在剩下的选项里挑最长的,同一个学生在生成卷上到 50.1%,MMLU 上是 28.1%。
怎么跑的
十六段英文材料,每段一百一十八到一百三十三词:十二段来自上一篇解析测试,另外四段写潮汐、冰川流动、锂离子电池和土壤结构。每段八道题,四选项,正确项必须能在材料里找到依据。模型是 deepseek-flash,温度 0.8,五十六次调用,一百零一秒,四百道题,没有一道少给,没有一道格式坏掉。中文那边换了十二段新材料,写点茶、伸缩缝、道岔、酱油、光纤色散、盐碱化、探空、析锂、越剧、空化、热岛和古籍脱酸,每段六道题。
第二套提示词只多一段家规:不写否定题干,选项里不用绝对词,不写「以上都是」「以上都不是」,四个选项要同一类、长度相近。其余完全一样,温度也一样。
人类那一边是 MMLU test 的 14,042 道四选项题和 ARC-Challenge test 的 1,144 道(原本 1,172 道,取其中四选项的),在 ECS 上从同一批 parquet 读,跟 11 月 6 日那篇长度体检用的是同一份文件。正则是一条,两个题库共用同一个函数;长度按去掉标点后的字符数算,这个口径在 MMLU 上算出来正是 28.6%,与 11 月 6 日发表的那个数对得上。
普通提示词留下了什么
| MMLU test,14,042 道 | 普通提示词,128 道 | 家规提示词,128 道 | |
|---|---|---|---|
| 选项里有绝对词的题 | 1,967(14.0%) | 34(26.6%) | 0 |
| 正确项本身带绝对词 | 730(37.1%) | 1(2.9%) | — |
| 只有一个选项带绝对词,且它就是正确项 | 420 / 1,390(30.2%) | 0 / 22 | — |
| 两个以上选项带绝对词 | 577(4.1%) | 12(9.4%) | 0 |
| 有「以上都是 / 以上都不是」选项 | 380(2.7%) | 0 | 0 |
比例只是小的一半,大的一半是绝对词落在哪个选项上。MMLU 的 1,967 道线索题里,有 730 道把绝对词放在正确项上,比瞎蒙指得准;当只有一个选项带绝对词时,那个选项是正确项的概率是 30.2%,接近瞎蒙的 25%。人写题时,绝对词两边都会用。
生成器把它当成错误选项的路标。34 道线索题里,1 道把绝对词放在正确项;22 道「只有一个选项带绝对词」的题里,一道都没有。这不是某一段材料的巧合:中文那边 11 道线索题,正确项 1 道,7 道只有一个选项带绝对词的题,没有一道命中。
ARC-Challenge 是小学科学题,这条线索少得多,1,144 道里 53 道,4.6%,其中 26 道落在正确项,49.1%。人写题时,always 和 all 是题目内容本身,出现在讲集合、讲全称判断的题里;生成的题把它们当错误选项的装饰。
中文那一半,同一个样子
| 普通提示词,72 道 | 家规提示词,72 道 | |
|---|---|---|
| 选项里有绝对词的题 | 11(15.3%) | 0 |
| 正确项本身带绝对词 | 1(9.1%) | — |
| 只有一个选项带绝对词,且它就是正确项 | 0 / 7 | — |
| 删掉绝对词选项再猜 | 26.5% | 25.0% |
| 同上一条,只算有这条线索的题 | 34.9%(11 道) | — |
| 删掉绝对词选项,再挑剩下里最长的 | 55.6% | 31.4% |
| 唯一最长的那一项就是正确项 | 69.8%(43 道) | 47.1%(17 道) |
十二段材料、每段六道题,线索出现的比例差不多,72 道里 11 道(15.3%),正确项 1 道,7 道只有一个选项带绝对词的题一道没中。不一样的是长度线索:72 道里 43 道有唯一最长选项,其中 30 道落在正确项,69.8%,所以闭卷组合策略到 55.6%,比英文的 50.1% 还高。家规把 11 道绝对词全清掉,组合策略掉到 31.4%,主要来自「长度相近」那半句,这也是这次测试里长度那句唯一看得出效果的地方。
两条规则,半张卷子
| 一个没读材料的学生 | MMLU,14,042 道 | 普通提示词,128 道 | 家规提示词,128 道 |
|---|---|---|---|
| 纯瞎猜 | 25.0% | 25.0% | 25.0% |
| 删掉带绝对词的选项,在剩下的里均分猜 | 25.0% | 29.2% | 25.0% |
| 同上一条,只算有这条线索的题 | 26.1%(1,871 道) | 41.9%(33 道) | — |
| 删掉绝对词选项,再在剩下的里挑最长的 | 28.1% | 50.1% | 41.1% |
| 唯一最长的那一项就是正确项 | 28.6%(11,645 道) | 48.3%(118 道) | 44.9%(107 道) |
看第三列。删绝对词这一条在生成卷上比瞎蒙高 4.2 个百分点,在 MMLU 上一点用没有,因为人写的题里这条线索同样可能落在正确项上。真正伤人的是第二条:删完再挑最长,128 道题上到 50.1%,是瞎蒙的两倍。
两条规则,不读材料,一半分。长度那一半是旧账,11 月 6 日用同两个人类题库量过,这次生成卷的数是 48.3%,人类的线是 28.6%。绝对词这一半是新的,而它可以被提示词里一句话关掉。
一句话的家规
第二套提示词加的就是这一段,别的没动:
这套题的规矩:不写否定题干(不要用「不正确」「不属于」「除了」「错误的是」);
选项里不用绝对词(全部、所有、一定、唯一、从不、完全、必然、绝对、只能、任何);
不写「以上都是」「以上都不是」;四个选项要是同一类东西,长度相近。
加了这段之后的两百道题,中英文合计,带绝对词的选项是 0 个,一道也没有。每次都按要求的道数返回,四选项齐全,没有重复选项。题干长度英文从 11.0 词到 10.4 词,中文从 19.2 字到 20.0 字,说明它不是靠把题干写空来换合规。真正变的是选项之间的长度差:英文一道题内选项长度的标准差从 1.19 词掉到 0.52 词;中文选项不但更齐,还变短了,平均从 7.8 字降到 6.3 字。
中文那一组还量到了这条家规对长度线索的影响:普通提示词下,唯一最长的选项落在正确项上是 69.8%,加家规之后 47.1%,而「存在唯一最长选项」的题从 43 / 72 掉到 17 / 72,这是「长度相近」那半句在起作用。英文只从 48.3% 挪到 44.9%,因为英文的错误选项靠措辞拉长度,一句「长度相近」管不到那么细。
家规没修好的部分
修好之后,英文卷上的组合策略还是 41.1%,人类线是 28.1%;只算长度线索,44.9% 对 28.6%。关掉绝对词线索,学生从 50.1% 掉到 41.1%,离一张干净的卷子还远。剩下的差距是选项长度方差,这个要靠给选项字符数设上限或者人工过一遍,再加一句提示词没有用。
否定题干这件事,量出来是零
家规里也禁了否定题干,这一条没花任何代价,因为普通提示词本来就没写:中英文合计四百道题,题干里靠 not、except、least、false、incorrect 立起来的,零道。MMLU 里有 2,219 道,占题库 15.8%,所以这个担心在人写的卷子里是真的,「以下哪项不正确」是标准题型。这个模型在四百道题里一次都没走这条路。
这是一个模型、一个温度下的结果,不能抄成「生成器不写否定题干」写进检查清单。能说的是:这一条在这里是免费的,留着,别再把审题时间花在一个没出现的故障上。
两道原题
英文普通组,酸面团那段。题干问:在冰箱里放了一周的面团,跟当天喂过的比怎么样。选项里有正确项「它仍在缓慢发酵,所以面团会更酸」,还有「它完全停止发酵」。材料用很直白的话否掉了后一句。一个知道「完全」是个警报词的学生,一秒就把它删了。
中文组,桥梁伸缩缝那段。题干问伸缩缝成为桥面最易损部位的主要原因,错误选项是「桥梁长度一定过长」,一个材料里根本没有的绝对判断,正确项是「车辆冲击、雨水和杂物集中在缝隙里」。同样的构造,换一种语言,路标仍然挂在错误选项上。
可以照抄的检查
把题导出成 CSV,表头 stem,a,b,c,d,answer,answer 用小写字母,跑下面这段。它打印四行:多少道题带线索、线索落在正确项上几次、两条学生规则各能拿多少分。
import csv, re, sys

ABS = re.compile(r"\b(always|never|all|none|only|entirely|completely|impossible|solely|sole)\b", re.I)

def norm(s):
    return len(re.sub(r"[^a-z0-9 ]+", " ", str(s).lower()).strip())

def load(path):
    rows = []
    with open(path, newline="", encoding="utf-8-sig") as f:
        for r in csv.DictReader(f):
            opts = [r.get(k, "").strip() for k in "abcd"]
            ans = str(r.get("answer", "")).strip().lower()
            if not all(opts) or ans not in "abcd" or len(ans) != 1:
                continue
            rows.append((opts, "abcd".index(ans)))
    return rows

def main(path):
    rows = load(path)
    n = len(rows)
    cue = sum(1 for o, a in rows if any(ABS.search(x) for x in o))
    keyed = sum(1 for o, a in rows if ABS.search(o[a]))
    drop = comb = 0.0
    for o, a in rows:
        keep = [i for i, x in enumerate(o) if not ABS.search(x)]
        if not keep:
            continue
        drop += (1.0 / len(keep)) if a in keep else 0.0
        top = [i for i in keep if norm(o[i]) == max(norm(o[j]) for j in keep)]
        comb += (1.0 / len(top)) if a in top else 0.0
    print("items %d" % n)
    print("items with an absolute-word option %d (%.1f%%)" % (cue, 100.0 * cue / n))
    print("keyed option carries an absolute word %d (%.1f%% of the cue items)" % (keyed, 100.0 * keyed / max(cue, 1)))
    print("drop absolute options, guess        %.1f%%" % (100.0 * drop / n))
    print("drop absolute, then longest         %.1f%%" % (100.0 * comb / n))
    print("chance                              25.0%")

if __name__ == "__main__":
    main(sys.argv[1])
在普通提示词那 128 道英文题上,它打印 34 道、2.9%、29.2%、50.1%;加家规的同一批 128 道上,打印 0 道、0.0%、25.0%、41.1%。判据两条:带绝对词的题占比高过 MMLU 的 14.0%,说明这套题多了一条人写题没有的线索;组合策略的分数离 50% 不到十个百分点,说明这套题还不能进教室。中文把词表换掉,算式不动:全部、所有、一定、唯一、从不、完全、必然、绝对、只能、任何。
这测不出什么
一个模型、一个温度,英文每套 128 道,中文每套 72 道。正则很机械:only 会把「not only」算进去,all 会把「all real numbers」算进去,所以 MMLU 那个 14.0% 含一部分良性命中,生成的 26.6% 里大概也有几道。MMLU 是知识题,绝对词是内容本身;按材料出题是另一个体裁,14.0% 是参照线,不是目标。没有人真去考试,那些分数是按规则算出来的期望值,不是观察到的答卷。家规是整段一起测的,中文从 69.8% 掉到 47.1% 不能全记在「长度相近」那半句上。
可以直接拿去用的:普通提示词把绝对词放在错误选项上 34 次、放在正确项上 1 次;人写的题库同一条线索 37.1% 指向正确项;一句家规把这条线索清零,一道题都没少。把导出文件当卷子读的那几项检查在解析怎么验;长度线索在人类题库里的位置是 11 月 6 日在28.6% 那次体检量的;十道题实际只考几个句子在覆盖计数;这些提示词要塞进去的九个免费工具在九个免费出题工具的实际边界。带走两个数:34 道带线索,1 道落在正确项。
相关文章
本站文章由编辑人工撰写,收录的工具均经过实测或公开资料核验。文中链接指向工具官网或 GitHub 仓库,仅作信息参考,不构成付费推广。