一千次 RAG 问答的账单:两万一千 token 的文档
RAG 花销按文档数量估,以为索引贵,说不清取四段还是两段值不值那点差价。
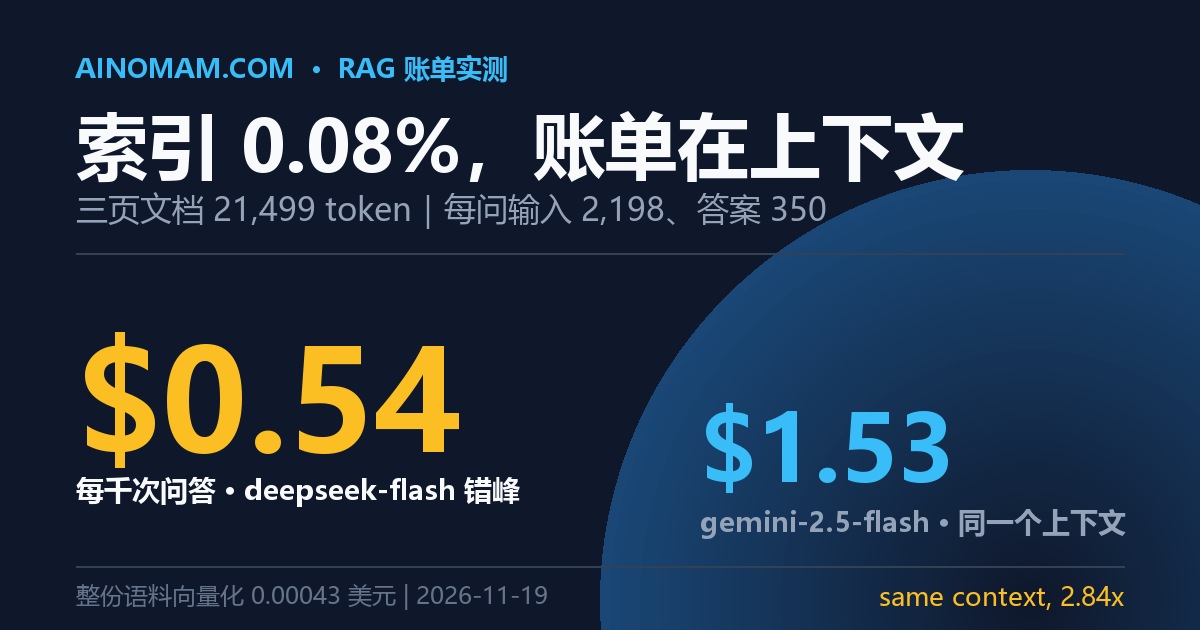
做预算的人盯着索引,付钱的地方在上下文窗口。三页技术文档的语料,整份向量化成本是0.043 美分;一千次问答的成本在 0.54 美元到 1.53 美元之间,取决于谁生成答案。索引只占第一张账单的 0.08%。拿文档数量估 RAG 花销,估的是小的那一头。
测了什么,怎么测的
三页真实文档,2026 年 11 月 19 日抓取:LiteLLM 代理配置文档、vLLM 优化文档、RAGFlow 的 README。去掉脚本和标签后,用 tiktoken 的 cl100k_base 编码分词——和 GPT-3.5/4 一代同一个分词器家族,对 DeepSeek 和 Gemini 用来做预算也够接近。切片按 512 token、重叠 64 token。
| 页面 | 正文字符 | token | 512 token 切片 |
|---|---|---|---|
| LiteLLM 代理配置 | 35192 | 8842 | 20 |
| vLLM 优化文档 | 38008 | 8180 | 19 |
| RAGFlow README | 16932 | 4477 | 10 |
| 合计 | 90132 | 21499 | 49 |
两个值得记住的数:平均 4.19 个字符一个 token,一页技术文档平均 7166 token。按这个密度,一百页的内部 wiki 大约 71.6 万 token。字符比低于常说的「四个字符一个 token」,因为接口文档里全是代码和标识符,这类内容分词效率差。
账单第一行:索引
按每百万输入 token 0.02 美元的向量模型(text-embedding-3-small,价格取 LiteLLM 价格表,11 月 19 日),21499 token 的向量化成本是 0.00043 美元;那一百页 wiki 是 0.0143 美元。整份语料每天全量重跑一年,不到四美元。这也是为什么「向量数据库很贵」几乎从来不是真的:这个量级下 pgvector 和 Qdrant 的每向量边际成本都是零,许可证也不是瓶颈。
账单第二行:塞给模型的上下文
检索才是花钱的地方。每问一次,取回 top-k 个切片,每个切片都是每一次提问都要重复付一次的输入 token,而语料只付一次。k=4 时是 2048 token 的段落,加上 150 token 的指令和问题,每次提问输入 2198 token;答案 350 token 就是 350 个输出 token。
下面的价格按每百万 token 计,2026 年 11 月 19 日核对:deepseek-flash 取 DeepSeek 官方定价页(未命中缓存输入错峰 0.15、峰时 0.30;输出错峰 0.60、峰时 1.20),gemini-2.5-flash 与 gpt-5-mini 取 LiteLLM 价格表(0.30/2.50 与 0.25/2.00)。LiteLLM 的表比厂商页面滞后,这两家按预算数用,签约前回官网再核一遍。
| 模型 | 输入,每千次 | 输出,每千次 | 合计 |
|---|---|---|---|
| deepseek-flash 错峰 | 0.330 | 0.210 | 0.540 |
| deepseek-flash 峰时 | 0.659 | 0.420 | 1.079 |
| gpt-5-mini | 0.549 | 0.700 | 1.250 |
| gemini-2.5-flash | 0.659 | 0.875 | 1.534 |
每月一万次(约每天三百三十次),落点 5.4 到 15.3 美元。纠结要不要做这件事的人应该先看到这个数:它根本不构成一个预算项。真正值得在意的是那 2.8 倍的差距,因为它会等比放大——每月一百万次时,就是 540 美元对 1534 美元。
杠杆一:取几段
| 保留段落 | 每次输入 token | 每千次,deepseek-flash 错峰 | gemini-2.5-flash |
|---|---|---|---|
| 2 | 1174 | 0.386 | 1.227 |
| 3 | 1686 | 0.463 | 1.381 |
| 4 | 2198 | 0.540 | 1.534 |
| 6 | 3222 | 0.693 | 1.842 |
这里和常见的建议相反。从四段砍到两段,每千次省 0.154 美元;每月十万次是 15 美元。如果问答质量正卡在「有用」和「出错」之间——我们自己在六十道题上的测试里,给模型四段检索材料把答对数从 21 提到 47——那么为了每月 15 美元砍掉一半材料是很差的交易。先算清旋钮值多少钱,再按质量决定停在哪。
杠杆二:答案长度
输出 token 的价格是输入的 4 到 8 倍,所以答案写多长是整张账单上最大的一个旋钮。同样 2198 token 输入,三种答案长度:
| 答案 token | deepseek-flash 错峰 | gemini-2.5-flash |
|---|---|---|
| 150 | 0.420 | 1.034 |
| 200 | 0.450 | 1.159 |
| 350 | 0.540 | 1.534 |
| 500 | 0.630 | 1.909 |
要求答案控制在 200 token 而不是 350,DeepSeek 省 16.7%,Gemini 省 24.4%。这比把材料砍一半省得多,而且很少让答案变差——长答案多半是同样两句话外围的填充。「答案不超过一百五十词,标出出处」是这套系统里最便宜的一次改动。
杠杆三:可缓存的前缀
每道题前面那段指令是同样的文字。DeepSeek 的缓存命中输入按每百万 0.003 美元计,未命中 0.15 美元,差五十倍。把固定部分放在最前面、一个字不改,缓存住 2198 个输入 token 里的 1000 个,每千次账单从 0.540 美元降到 0.393 美元,省 27.2%,峰时同样是 27.2%。代价是前缀必须逐字节一致且排在最前:系统提示里混进一个会变的时间戳,缓存就静默失效。
把这套测算复现一遍
在自己语料上跑,不要直接信上面的数——散文 wiki 和接口文档的密度差得足够多,结论会变。
import tiktoken
enc = tiktoken.get_encoding("cl100k_base")
text = open("doc.md", encoding="utf-8").read()
ids = enc.encode(text)
step, chunks, i = 512 - 64, 0, 0
while i < len(ids):
    chunks += 1
    i += step
print(len(text), len(ids), round(len(text)/len(ids), 2), chunks)
然后乘:第一行是 token/100万 乘向量单价;第二行是(保留段数乘切片大小加指令)乘问题数乘输入单价,加上答案 token 乘问题数乘输出单价。RAG 账单上别的东西,和这两行比都是零头。
这篇没覆盖的
没有延迟,没有四家模型的质量对比,也没有重排成本——多数厂商的重排按每次检索计费而不是按 token,套不进这套算法,所以直接排除而不是估算。token 数来自一个和 DeepSeek、Gemini 不完全相同的分词器,上下浮动几个百分点,不影响上面任何一条结论。文档解析那段见 解析方案对比,在优化价格之前先确认答案对不对,见 RAGAS 评测那一篇。
相关文章
本站文章由编辑人工撰写,收录的工具均经过实测或公开资料核验。文中链接指向工具官网或 GitHub 仓库,仅作信息参考,不构成付费推广。